Lokal AI på en 32 GB M1 Pro: Det er ikke nok, at modellen kan være i hukommelsen
En MacBook Pro med 32 GB kan køre overraskende store lokale AI-modeller. Men vores test viste, at en model godt kan være i hukommelsen og stadig være frustrerende langsom, når konteksten bliver stor.
Hvis du vælger hardware til lokal AI, er det oplagte spørgsmål ofte: Kan modellen være i hukommelsen?
Det viste sig at være for simpelt et spørgsmål. Vi testede Qwen2.5-modeller fra 3B til 32B på en MacBook Pro med M1 Pro og 32 GB samlet hukommelse. Flere af de fastlåste opsætninger blev gennemført uden observeret swap, men lange prompts kunne stadig få modellen til at bruge flere minutter på at begynde at svare.
Vi så også en større og mere komprimeret opsætning bestå flere diagnostiske opgaver end en mindre model med højere præcision. Både modelstørrelse og kvantisering var forskellige, så sammenligningen viser ikke, hvilken ændring der gjorde forskellen.
Det nyttige spørgsmål er derfor ikke kun, hvad Mac’en kan køre, men hvilke opsætninger der er praktiske til opgaven og den ventetid, man kan acceptere.
Med en kort prompt begyndte de samme opsætninger at svare efter cirka 0,9–1,8 sekunder. Med en prompt på omtrent 30.700 tokens var ventetiden 3 min. 37 sek. til 7 min. 53 sek. Det er tid til første token, altså hvor længe du venter, før modellen begynder at svare. Det er ikke tiden, det tager at skrive hele svaret.
Hvor længe går der, før modellen begynder at svare?
Søjlerne bruger en lineær skala fra 0 til 8 minutter. Med korte prompts begyndte alle tre opsætninger på under to sekunder.
- 7B Q4, 32K kontekst3 min. 37 sek.
- 14B Q4, 32K kontekst, q8 KV7 min. 52 sek.
- 14B Q4, 32K kontekst7 min. 53 sek.
Hele sammenligningen
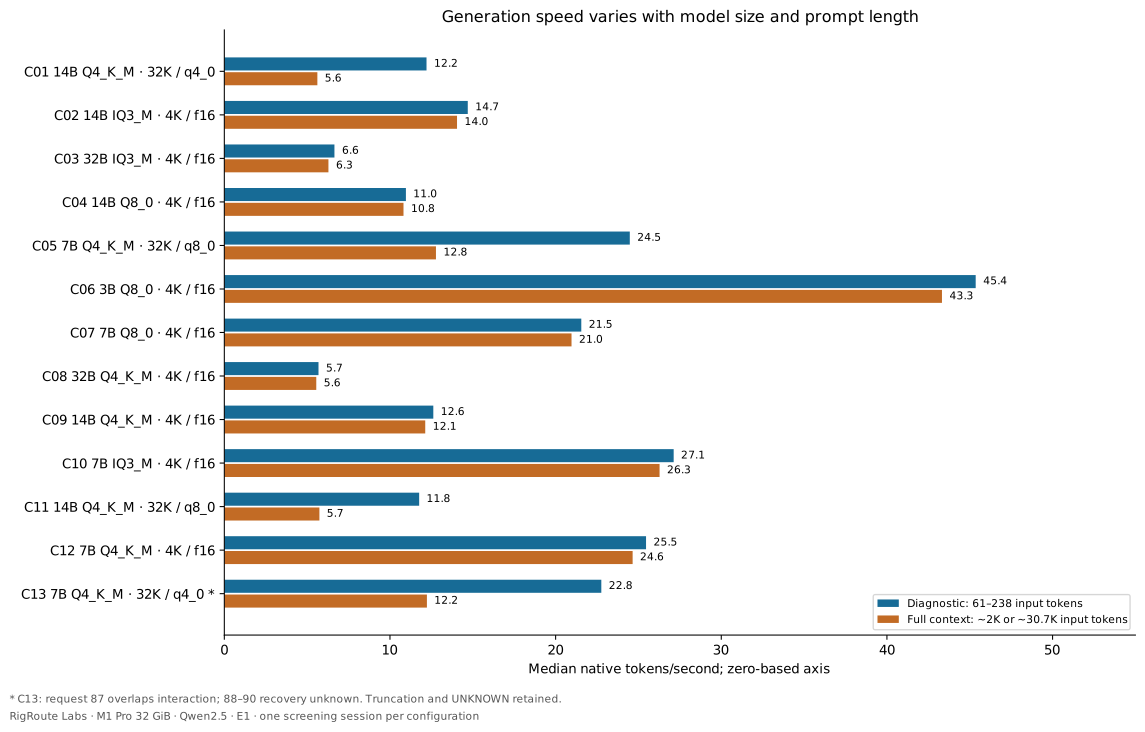
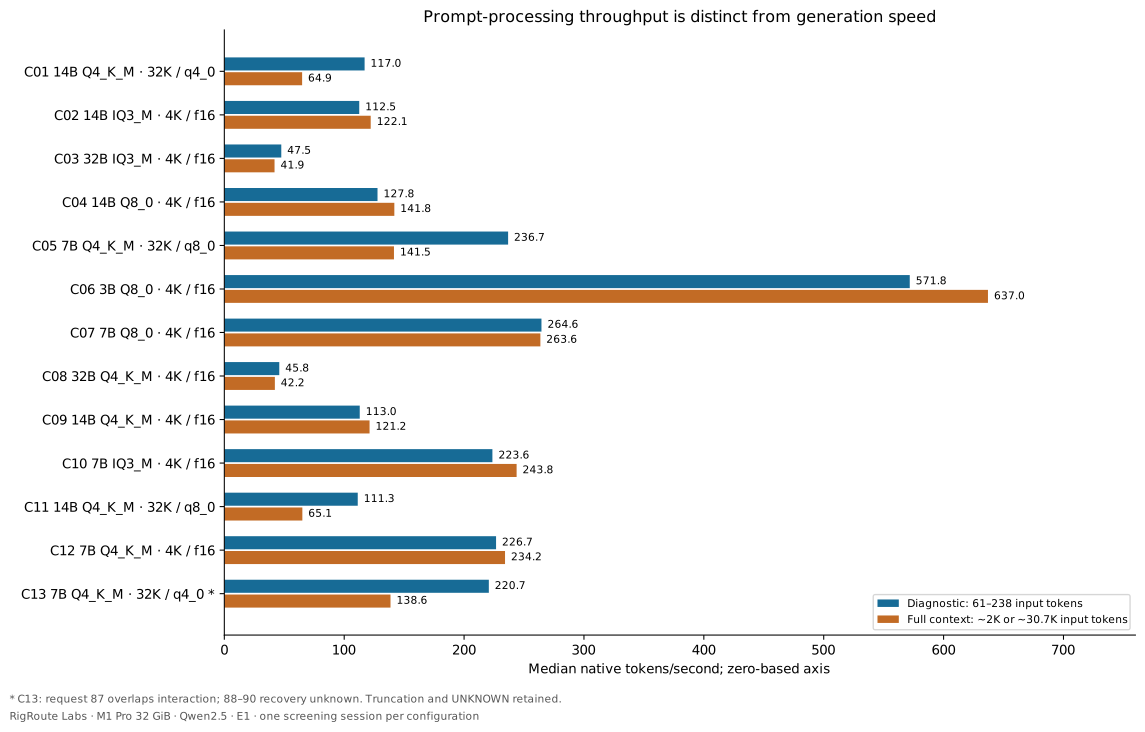
Den detaljerede figur nedenfor viser alle 13 konfigurationer og bevarer den sidste celle med dens interaktionsnoter. De korte input var cirka 210–225 tokens; de lange input var cirka 2.040 tokens i 4K-cellerne og cirka 30.700 tokens i 32K-cellerne.
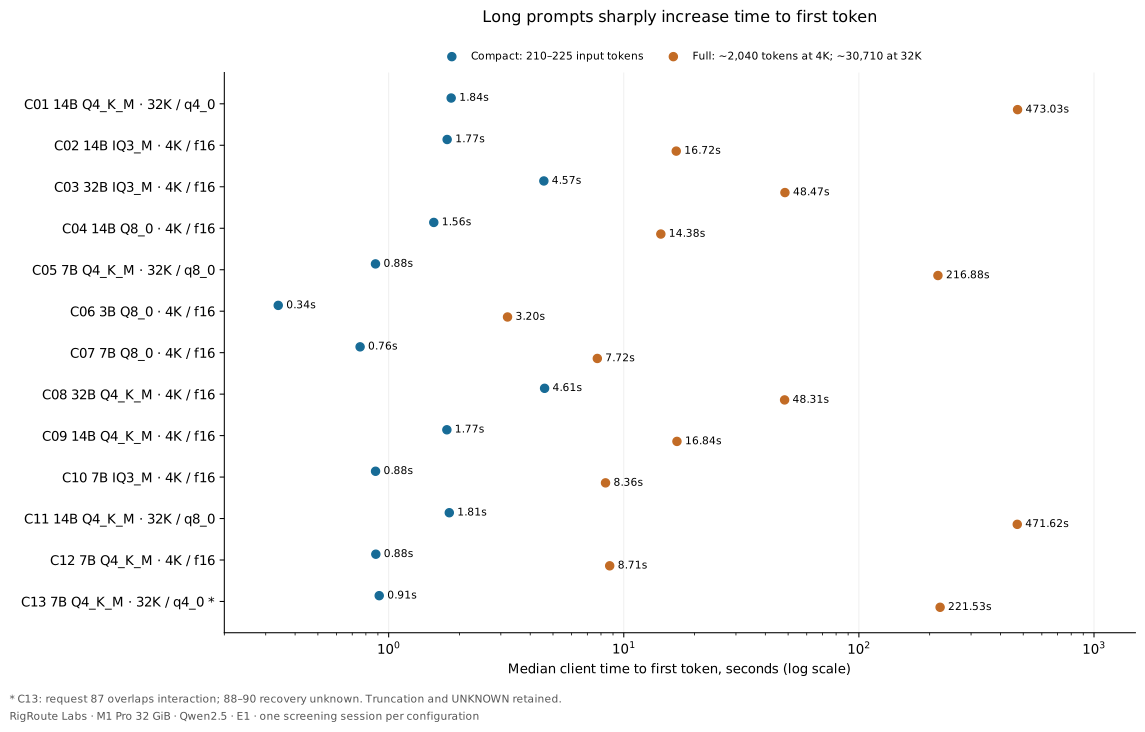
Lange prompts ændrer ventetiden markant
De tre udvalgte 32K-kørsler viser samme mønster: korte prompts begyndte at svare efter 0,879–1,844 sekunder, mens fulde prompts brugte 216,882–473,025 sekunder på at give første token. Det er cirka 247–260 gange længere, når man sammenligner medianerne for betingelserne. Målingen viser ikke, hvor lang tid et helt svar tog.
| Model / KV | TTFT, kort prompt | TTFT, fuld prompt | Fuld prompt | Fuld generering | Fuld P/F/U |
|---|---|---|---|---|---|
| 14B Q4_K_M / q4_0 | 1.844 s | 473.025 s | 64.90 tok/s | 5.62 tok/s | 14 / 4 / 0 |
| 7B Q4_K_M / q8_0 | 0.879 s | 216.882 s | 141.52 tok/s | 12.78 tok/s | 1 / 17 / 0 |
| 14B Q4_K_M / q8_0 | 1.811 s | 471.615 s | 65.10 tok/s | 5.74 tok/s | 16 / 2 / 0 |
For 14B/q8_0 KV-opsætningen var genereringen 11,69 tok/s efter en kort prompt og 5,74 tok/s efter en fuld prompt. For 7B/q8_0 KV var den 23,65 og 12,78 tok/s. Lange prompts påvirkede både ventetiden før start og hastigheden, efter at genereringen begyndte.
Forespørgslerne genbrugte ingen KV-cache-tokens. Vi ryddede eller målte ikke styresystemets diskcache, og vi testede ikke en retrieval-pipeline. Her gav en kortere prompt hurtigere første token; vi undersøgte ikke, om automatisk udvælgelse af tekst ville bevare de fakta, opgaven kræver.
Ingen observeret swap betød ikke, at der ikke var ventetid
På tværs af 318.240 telemetrimålinger fra modellen var den registrerede hukommelsespresstatus normal. Den højeste rapporterede swap-brug var nul, og tællerne for swap ind og ud steg ikke i nogen celle. Værtens hukommelseskomprimering var aktiv.
Målingerne dækker ikke al samlet GPU-/modelallokering eller den tilgængelige hukommelsesreserve. Vi kender GGUF-filstørrelserne, men ikke hele runtime-aftrykket. Den præcise konklusion er smallere: Vi observerede ikke swapping i de målte perioder. Fri hukommelse og omkostningen ved hukommelseshåndtering blev ikke målt.
Hvad mindre modelfiler gav, og ikke gav
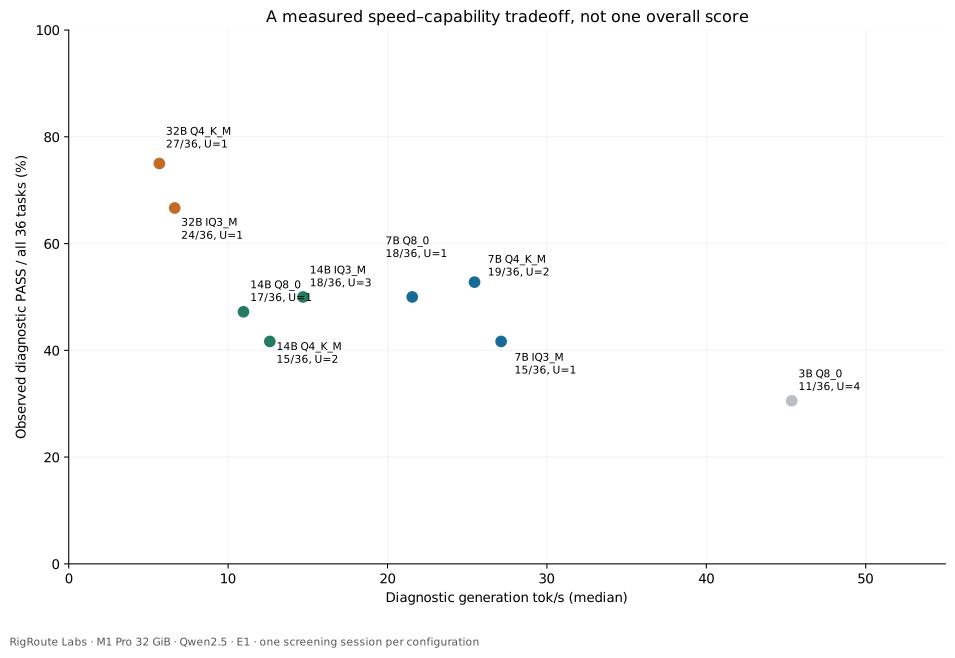
Ved 4K/f16 bestod 32B IQ3 24 af 36 diagnostiske opgaver; 14B Q8 bestod 17. 32B IQ3-filen var mindre (13,793 GiB mod 14,623 GiB), men genererede langsommere (6,65 mod 10,96 tok/s). Det er en sammenligning af to komplette opsætninger: både modelstørrelse og kvantisering ændres, så årsagen isoleres ikke.
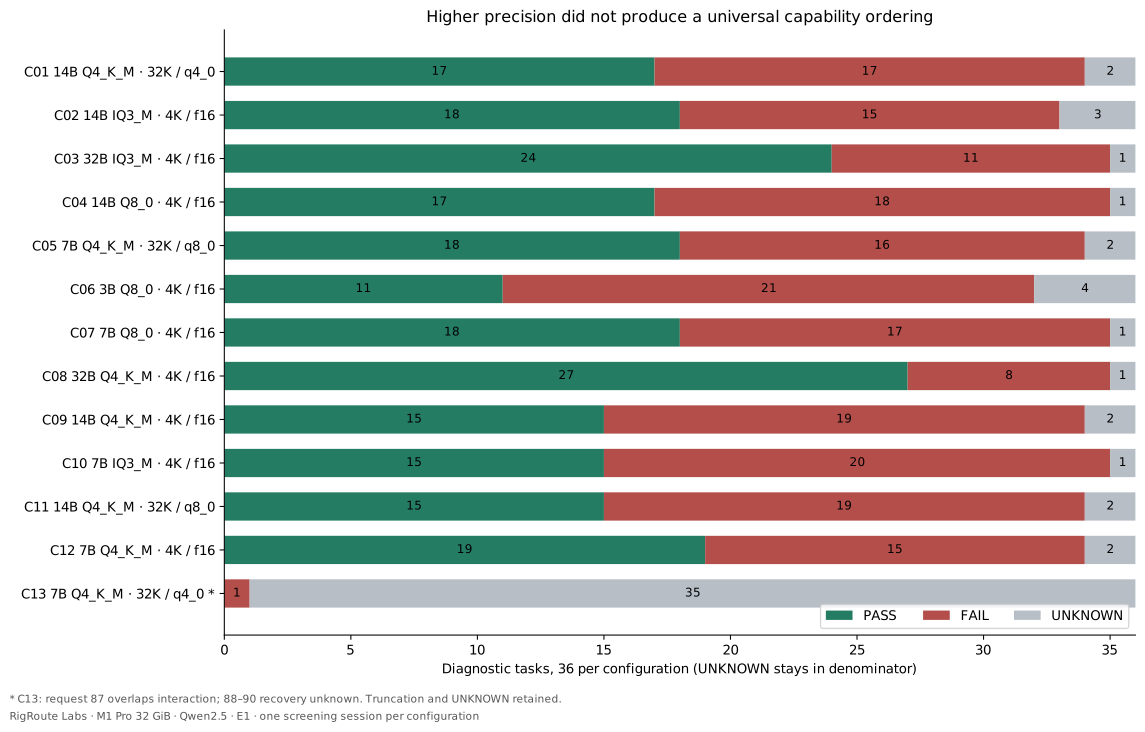
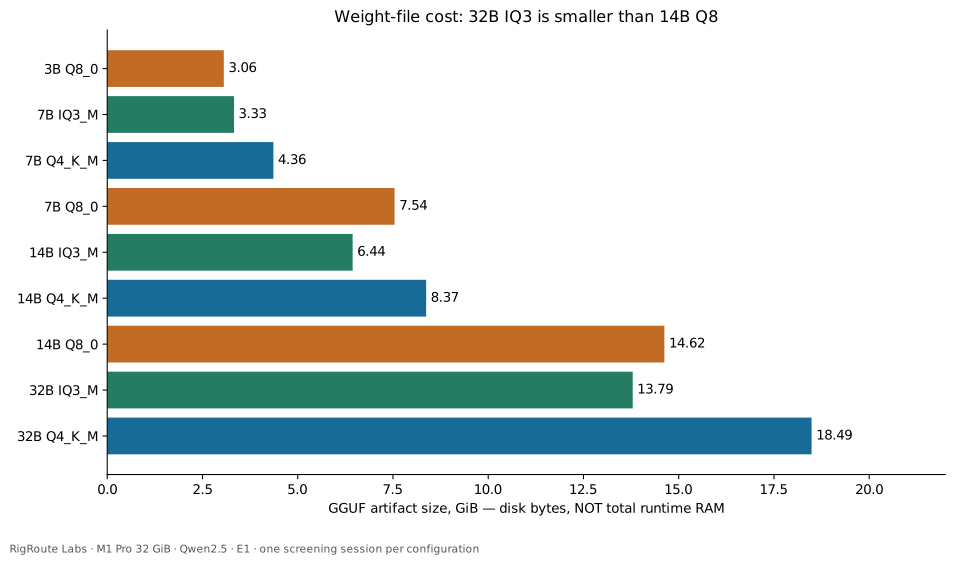
Kvantisering gav ikke én fast rangorden. Ved 7B bestod Q4 19 diagnostiske opgaver, IQ3 bestod 15, og Q8 bestod 18. IQ3 sparede 1,033 GiB i forhold til Q4 og genererede 6,6 % hurtigere, men bestod fire færre opgaver. Ved 14B bestod IQ3 18, Q8 bestod 17, og Q4 bestod 15. Ved 32B bestod Q4 27, tre flere end IQ3; til gengæld var filen 4,695 GiB større, og genereringen var langsommere.
De små forskelle kommer fra ét testsæt med 36 opgaver. De viser ikke, at IQ3 forbedrer ræsonnement, svarer til Q8, eller at Q4 altid er bedst. Q8 behandlede korte prompts hurtigere i nogle matchede sammenligninger. IQ3 brugte færre filbytes og genererede nogle gange hurtigere. Resultatet afhang af modelstørrelse og opgave.
Et 14B-midtpunkt med et forbehold om opgaverne
Til dette opgavesæt er 14B IQ3/4K/f16 en foreløbig kandidat til en god balance. Modelfilen var 6,442 GiB; den nåede 14,70 diagnostiske tok/s og bestod 18/36 opgaver. Den bestod 18/18 opgaver med fuldt evidensgrundlag ved cirka 2K inputtokens. Medianen for tid til første token var 1,773 sekunder med korte prompts og 16,718 sekunder med fulde prompts.
7B Q4 var hurtigere med 25,46 tok/s og bestod én diagnostisk opgave mere (19/36), men bestod 8/18 opgaver med fuldt evidensgrundlag. Derfor er 14B IQ3 en balancekandidat her, ikke en vinder til alle arbejdsopgaver.
Til korte opgaver, hvor svaret kan kontrolleres, var 3B Q8 den mindste og hurtigste testede mulighed: 3,060 GiB på disk, 45,36 diagnostiske tok/s og 0,339 sekunders tid til første token med kort prompt. Den bestod 11/36 opgaver. 32B Q4 lå øverst i matricen med 27/36, 5,69 tok/s og 4,605 sekunders tid til første token med kort prompt. De ekstra opgavebeståelser er ikke nødvendigvis ventetiden værd i alle situationer.
Ved 32K bestod 7B Q4 med q8_0 KV 1/18 opgaver med fuldt evidensgrundlag efter 216,882 sekunders ventetid. 14B Q4 med samme KV-indstilling bestod 16/18 efter 471,615 sekunder. En kontekstindstilling bestemmer, hvor meget tekst runtime kan modtage; den viser ikke, at al teksten er nyttig dokumentation.
Hvad sammenligningen af KV-cache ikke kan fortælle
Ved 14B Q4 og 32K var ventetiden med fuld prompt næsten ens for q4_0 og q8_0 KV: 473,025 og 471,615 sekunder. q8_0-cellen bestod 16/18 fulde opgaver; q4_0 bestod 14/18. De målte toppe i procesaftryk var 3,350 GiB med q8_0 og 1,848 GiB med q4_0, men de målinger dækker ikke hele den samlede GPU-hukommelse og isolerer ikke KV-bytes. Vi testede ikke 32K med f16 KV, så den største brugbare kontekstforlængelse er ukendt.
Ét resultat kræver et særskilt forbehold. 7B Q4 ved 32K/q4_0 gav gentagende, ubrugelige svar allerede fra de første diagnostiske forespørgsler. Alle 36 diagnostiske forespørgsler lå før VS Code blev åbnet; graderingen var 0 PASS, 1 FAIL og 35 UNKNOWN. Den senere interaktion forklarer altså ikke den første afvigelse. Årsagen er ukendt, og denne ene celle viser ikke, at q4_0 KV generelt fejler.
Hvad vi testede, og hvad E1 betyder
Vi brugte en fastlåst Metal-build af llama.cpp, build 11146 fra kildekodecommit 7fe450e19, på én Apple M1 Pro med 32 GiB samlet hukommelse. Matricen dækker Qwen2.5 Instruct-modeller i størrelserne 3B, 7B, 14B og 32B med IQ3_M-, Q4_K_M- eller Q8_0-vægte. Ni konfigurationer brugte 4K/f16 KV. Fire brugte 32K med Q4-vægte og q4_0 eller q8_0 KV. Den præcise matrix og identifikatorerne er linket nedenfor.
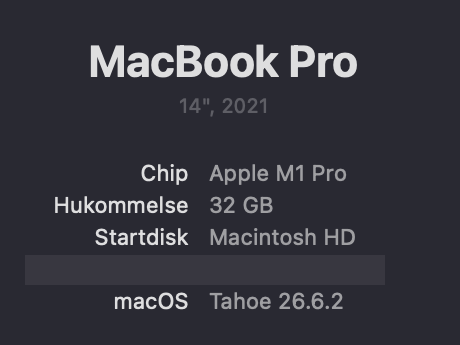
Hver konfiguration brugte 36 syntetiske diagnostiske opgaver og 54 syntetiske kontekstforespørgsler med fuldt, kort eller manglende evidens. Der var én session pr. konfiguration. Evidensniveau E1 betyder et udforskende resultat fra en kontrolleret screening på én maskine; det er ikke uafhængigt gentaget. Der er ikke beregnet konfidensintervaller. Resultaterne kan ikke uden videre overføres til en anden Mac, AMD- eller NVIDIA-hardware eller en udviklermaskine med andre programmer åbne.
I den sidste konfiguration blev forespørgsel 1–86 færdig før VS Code blev åbnet. Forespørgsel 87 overlappede med bekræftet VS Code-aktivitet. Forespørgsel 88–90 er fortsat ukendte, fordi processens afslutning ikke blev registreret. Alle 36 diagnostiske forespørgsler lå før opstarten. De sene forespørgsler er stadig med i de detaljerede data med separate markeringer, men de driver ikke hovedresultatet. Et tidligere, delvist forsøg med 7B IQ3 er bevaret separat; dets svar er ikke blandet med den gennemførte kørsel.
Her betyder “kan køre”, at den præcise, fastlåste kørsel blev gennemført. “Nyttig” afhænger af opgaveresultaterne og af, hvor længe du vil vente. “Balanceret” er en redaktionel vurdering for dette opgavesæt, ikke en fast tærskel eller en generel købsanbefaling.
Resultater og kildemateriale
De offentlige filer indeholder afledte tabeller og figurdata. De indeholder ikke rå prompt- og svarjournaler, modelfiler, lokale filstier eller værtens klokkespor.
- Komplet resultatredegørelse (Markdown)
- Hele den læsbare resultatmatrix (Markdown)
- Konfigurationsresultater (CSV)
- Strukturerede konfigurationsresultater (JSON)
- Afledte opgaveresultater (CSV)
- Påstande og begrænsninger (Markdown)
- Stage 1A-protokoloversigt (reproducerbarhedsreference)
- Labs-metodeoversigt (Standard-ai-v0.1-oversigten beskriver et andet benchmark; Stage 1A-protokollen er linket ovenfor.)
- Testet Apple M1 Pro-system
Tekniske figurer
- Genereringshastighed (SVG)
- Promptbehandlingshastighed (SVG)
- Hastighed og diagnostiske resultater (SVG)
De seks figurer viser denne screening. Akser og inkluderede celler er beskrevet i figurmanifestet. Figurmanifestet.
Metode- og auditreferencer bruger fortsat undersøgelsens interne identifikator.